712.两个字符串的最小ASCII删除和

目标

给定两个字符串s1 和 s2,返回 使两个字符串相等所需删除字符的 ASCII 值的最小和 。

示例 1:

输入: s1 = "sea", s2 = "eat"
输出: 231
解释: 在 "sea" 中删除 "s" 并将 "s" 的值(115)加入总和。
在 "eat" 中删除 "t" 并将 116 加入总和。
结束时,两个字符串相等,115 + 116 = 231 就是符合条件的最小和。

示例 2:

输入: s1 = "delete", s2 = "leet"
输出: 403
解释: 在 "delete" 中删除 "dee" 字符串变成 "let",
将 100[d]+101[e]+101[e] 加入总和。在 "leet" 中删除 "e" 将 101[e] 加入总和。
结束时,两个字符串都等于 "let",结果即为 100+101+101+101 = 403 。
如果改为将两个字符串转换为 "lee" 或 "eet",我们会得到 433 或 417 的结果,比答案更大。

说明:

  • 0 <= s1.length, s2.length <= 1000
  • s1 和 s2 由小写英文字母组成

思路

代码

性能

1411.给Nx3网格图涂色的方案数

目标

你有一个 n x 3 的网格图 grid ,你需要用 红,黄,绿 三种颜色之一给每一个格子上色,且确保相邻格子颜色不同(也就是有相同水平边或者垂直边的格子颜色不同)。

给你网格图的行数 n 。

请你返回给 grid 涂色的方案数。由于答案可能会非常大,请你返回答案对 10^9 + 7 取余的结果。

示例 1:

输入:n = 1
输出:12
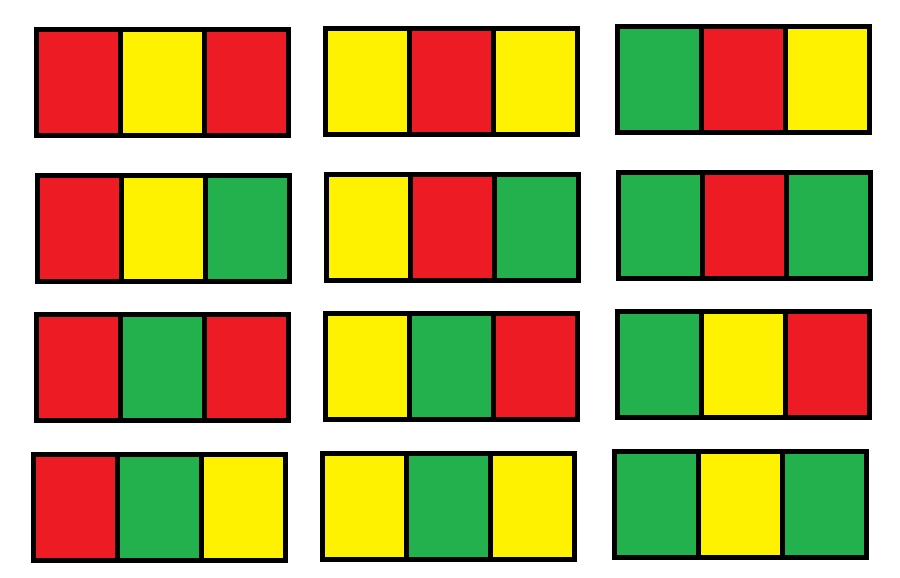
解释:总共有 12 种可行的方法:

示例 2:

输入:n = 2
输出:54

示例 3:

输入:n = 3
输出:246

示例 4:

输入:n = 7
输出:106494

示例 5:

输入:n = 5000
输出:30228214

说明:

  • n == grid.length
  • grid[i].length == 3
  • 1 <= n <= 5000

思路

代码

性能

3573.买卖股票的最佳时机V

目标

给你一个整数数组 prices,其中 prices[i] 是第 i 天股票的价格(美元),以及一个整数 k。

你最多可以进行 k 笔交易,每笔交易可以是以下任一类型:

  • 普通交易:在第 i 天买入,然后在之后的第 j 天卖出,其中 i < j。你的利润是 prices[j] - prices[i]。
  • 做空交易:在第 i 天卖出,然后在之后的第 j 天买回,其中 i < j。你的利润是 prices[i] - prices[j]。

注意:你必须在开始下一笔交易之前完成当前交易。此外,你不能在已经进行买入或卖出操作的同一天再次进行买入或卖出操作。

通过进行 最多 k 笔交易,返回你可以获得的最大总利润。

示例 1:

输入: prices = [1,7,9,8,2], k = 2
输出: 14
解释:
我们可以通过 2 笔交易获得 14 美元的利润:
一笔普通交易:第 0 天以 1 美元买入,第 2 天以 9 美元卖出。
一笔做空交易:第 3 天以 8 美元卖出,第 4 天以 2 美元买回。

示例 2:

输入: prices = [12,16,19,19,8,1,19,13,9], k = 3
输出: 36
解释:
我们可以通过 3 笔交易获得 36 美元的利润:
一笔普通交易:第 0 天以 12 美元买入,第 2 天以 19 美元卖出。
一笔做空交易:第 3 天以 19 美元卖出,第 4 天以 8 美元买回。
一笔普通交易:第 5 天以 1 美元买入,第 6 天以 19 美元卖出。

说明:

  • 2 <= prices.length <= 10^3
  • 1 <= prices[i] <= 10^9
  • 1 <= k <= prices.length / 2

思路

代码

性能

3562.折扣价交易股票的最大利润

目标

给你一个整数 n,表示公司中员工的数量。每位员工都分配了一个从 1 到 n 的唯一 ID ,其中员工 1 是 CEO。另给你两个下标从 1 开始的整数数组 present 和 future,两个数组的长度均为 n,具体定义如下:

  • present[i] 表示第 i 位员工今天可以购买股票的 当前价格 。
  • future[i] 表示第 i 位员工明天可以卖出股票的 预期价格 。

公司的层级关系由二维整数数组 hierarchy 表示,其中 hierarchy[i] = [ui, vi] 表示员工 ui 是员工 vi 的直属上司。

此外,再给你一个整数 budget,表示可用于投资的总预算。

公司有一项折扣政策:如果某位员工的直属上司购买了自己的股票,那么该员工可以以 半价 购买自己的股票(即 floor(present[v] / 2))。

请返回在不超过给定预算的情况下可以获得的 最大利润 。

注意:

  • 每只股票最多只能购买一次。
  • 不能使用股票未来的收益来增加投资预算,购买只能依赖于 budget。

示例 1:

输入: n = 2, present = [1,2], future = [4,3], hierarchy = [[1,2]], budget = 3
输出: 5
解释:
员工 1 以价格 1 购买股票,获得利润 4 - 1 = 3。
由于员工 1 是员工 2 的直属上司,员工 2 可以以折扣价 floor(2 / 2) = 1 购买股票。
员工 2 以价格 1 购买股票,获得利润 3 - 1 = 2。
总购买成本为 1 + 1 = 2 <= budget,因此最大总利润为 3 + 2 = 5。

示例 2:

输入: n = 2, present = [3,4], future = [5,8], hierarchy = [[1,2]], budget = 4
输出: 4
解释:
员工 2 以价格 4 购买股票,获得利润 8 - 4 = 4。
由于两位员工无法同时购买,最大利润为 4。

示例 3:

输入: n = 3, present = [4,6,8], future = [7,9,11], hierarchy = [[1,2],[1,3]], budget = 10
输出: 10
解释:
员工 1 以价格 4 购买股票,获得利润 7 - 4 = 3。
员工 3 可获得折扣价 floor(8 / 2) = 4,获得利润 11 - 4 = 7。
员工 1 和员工 3 的总购买成本为 4 + 4 = 8 <= budget,因此最大总利润为 3 + 7 = 10。

示例 4:

输入: n = 3, present = [5,2,3], future = [8,5,6], hierarchy = [[1,2],[2,3]], budget = 7
输出: 12
解释:
员工 1 以价格 5 购买股票,获得利润 8 - 5 = 3。
员工 2 可获得折扣价 floor(2 / 2) = 1,获得利润 5 - 1 = 4。
员工 3 可获得折扣价 floor(3 / 2) = 1,获得利润 6 - 1 = 5。
总成本为 5 + 1 + 1 = 7 <= budget,因此最大总利润为 3 + 4 + 5 = 12。

说明:

  • 1 <= n <= 160
  • present.length, future.length == n
  • 1 <= present[i], future[i] <= 50
  • hierarchy.length == n - 1
  • hierarchy[i] == [ui, vi]
  • 1 <= ui, vi <= n
  • ui != vi
  • 1 <= budget <= 160
  • 没有重复的边。
  • 员工 1 是所有员工的直接或间接上司。
  • 输入的图 hierarchy 保证 无环 。

思路

代码

性能

3606.优惠券校验器

目标

给你三个长度为 n 的数组,分别描述 n 个优惠券的属性:code、businessLine 和 isActive。其中,第 i 个优惠券具有以下属性:

  • code[i]:一个 字符串,表示优惠券的标识符。
  • businessLine[i]:一个 字符串,表示优惠券所属的业务类别。
  • isActive[i]:一个 布尔值,表示优惠券是否当前有效。

当以下所有条件都满足时,优惠券被认为是 有效的 :

  1. code[i] 不能为空,并且仅由字母数字字符(a-z、A-Z、0-9)和下划线(_)组成。
  2. businessLine[i] 必须是以下四个类别之一:"electronics"、"grocery"、"pharmacy"、"restaurant"。
  3. isActive[i] 为 true 。

返回所有 有效优惠券的标识符 组成的数组,按照以下规则排序:

  • 先按照其 businessLine 的顺序排序:"electronics"、"grocery"、"pharmacy"、"restaurant"。
  • 在每个类别内,再按照 标识符的字典序(升序)排序。

示例 1:

输入: code = ["SAVE20","","PHARMA5","SAVE@20"], businessLine = ["restaurant","grocery","pharmacy","restaurant"], isActive = [true,true,true,true]
输出: ["PHARMA5","SAVE20"]
解释:
第一个优惠券有效。
第二个优惠券的标识符为空(无效)。
第三个优惠券有效。
第四个优惠券的标识符包含特殊字符 @(无效)。

示例 2:

输入: code = ["GROCERY15","ELECTRONICS_50","DISCOUNT10"], businessLine = ["grocery","electronics","invalid"], isActive = [false,true,true]
输出: ["ELECTRONICS_50"]
解释:
第一个优惠券无效,因为它未激活。
第二个优惠券有效。
第三个优惠券无效,因为其业务类别无效。

说明:

  • n == code.length == businessLine.length == isActive.length
  • 1 <= n <= 100
  • 0 <= code[i].length, businessLine[i].length <= 100
  • code[i] 和 businessLine[i] 由可打印的 ASCII 字符组成。
  • isActive[i] 的值为 true 或 false。

思路

代码

性能

3433.统计用户被提及情况

目标

给你一个整数 numberOfUsers 表示用户总数,另有一个大小为 n x 3 的数组 events 。

每个 events[i] 都属于下述两种类型之一:

  1. 消息事件(Message Event):["MESSAGE", "timestampi", "mentions_stringi"]

    • 事件表示在 timestampi 时,一组用户被消息提及。
    • mentions_stringi 字符串包含下述标识符之一:
      • id:其中 是一个区间 [0,numberOfUsers - 1] 内的整数。可以用单个空格分隔 多个 id ,并且 id 可能重复。此外,这种形式可以提及离线用户。
      • ALL:提及 所有 用户。
      • HERE:提及所有 在线 用户。
  2. 离线事件(Offline Event):["OFFLINE", "timestampi", "idi"]

    • 事件表示用户 idi 在 timestampi 时变为离线状态 60 个单位时间。用户会在 timestampi + 60 时自动再次上线。

返回数组 mentions ,其中 mentions[i] 表示 id 为 i 的用户在所有 MESSAGE 事件中被提及的次数。

最初所有用户都处于在线状态,并且如果某个用户离线或者重新上线,其对应的状态变更将会在所有相同时间发生的消息事件之前进行处理和同步。

注意 在单条消息中,同一个用户可能会被提及多次。每次提及都需要被 分别 统计。

示例 1:

输入:numberOfUsers = 2, events = [["MESSAGE","10","id1 id0"],["OFFLINE","11","0"],["MESSAGE","71","HERE"]]
输出:[2,2]
解释:
最初,所有用户都在线。
时间戳 10 ,id1 和 id0 被提及,mentions = [1,1]
时间戳 11 ,id0 离线 。
时间戳 71 ,id0 再次 上线 并且 "HERE" 被提及,mentions = [2,2]

示例 2:

输入:numberOfUsers = 2, events = [["MESSAGE","10","id1 id0"],["OFFLINE","11","0"],["MESSAGE","12","ALL"]]
输出:[2,2]
解释:
最初,所有用户都在线。
时间戳 10 ,id1 和 id0 被提及,mentions = [1,1]
时间戳 11 ,id0 离线 。
时间戳 12 ,"ALL" 被提及。这种方式将会包括所有离线用户,所以 id0 和 id1 都被提及,mentions = [2,2]

示例 3:

输入:numberOfUsers = 2, events = [["OFFLINE","10","0"],["MESSAGE","12","HERE"]]
输出:[0,1]
解释:
最初,所有用户都在线。
时间戳 10 ,id0 离线 。
时间戳 12 ,"HERE" 被提及。由于 id0 仍处于离线状态,其将不会被提及,mentions = [0,1]

说明:

  • 1 <= numberOfUsers <= 100
  • 1 <= events.length <= 100
  • events[i].length == 3
  • events[i][0] 的值为 MESSAGE 或 OFFLINE 。
  • 1 <= int(events[i][1]) <= 105
  • 在任意 "MESSAGE" 事件中,以 id 形式提及的用户数目介于 1 和 100 之间。
  • 0 <= <= numberOfUsers - 1
  • 题目保证 OFFLINE 引用的用户 id 在事件发生时处于 在线 状态。

思路

代码

性能

3625.统计梯形的数目II

目标

给你一个二维整数数组 points,其中 points[i] = [xi, yi] 表示第 i 个点在笛卡尔平面上的坐标。

返回可以从 points 中任意选择四个不同点组成的梯形的数量。

梯形 是一种凸四边形,具有 至少一对 平行边。两条直线平行当且仅当它们的斜率相同。

示例 1:

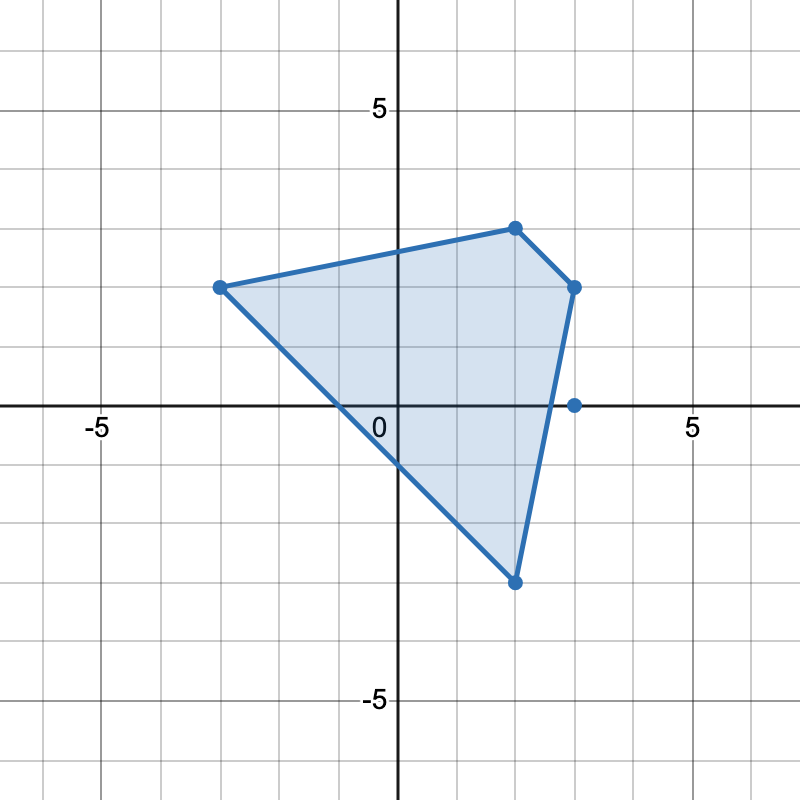
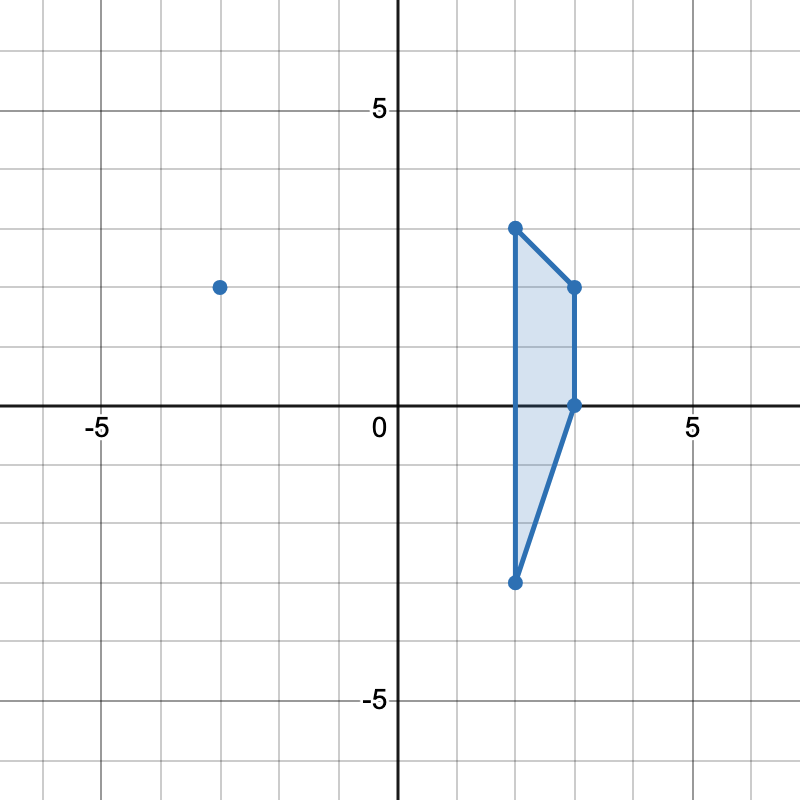
输入: points = [[-3,2],[3,0],[2,3],[3,2],[2,-3]]
输出: 2
解释:
有两种不同方式选择四个点组成一个梯形:
点 [-3,2], [2,3], [3,2], [2,-3] 组成一个梯形。
点 [2,3], [3,2], [3,0], [2,-3] 组成另一个梯形。

示例 2:

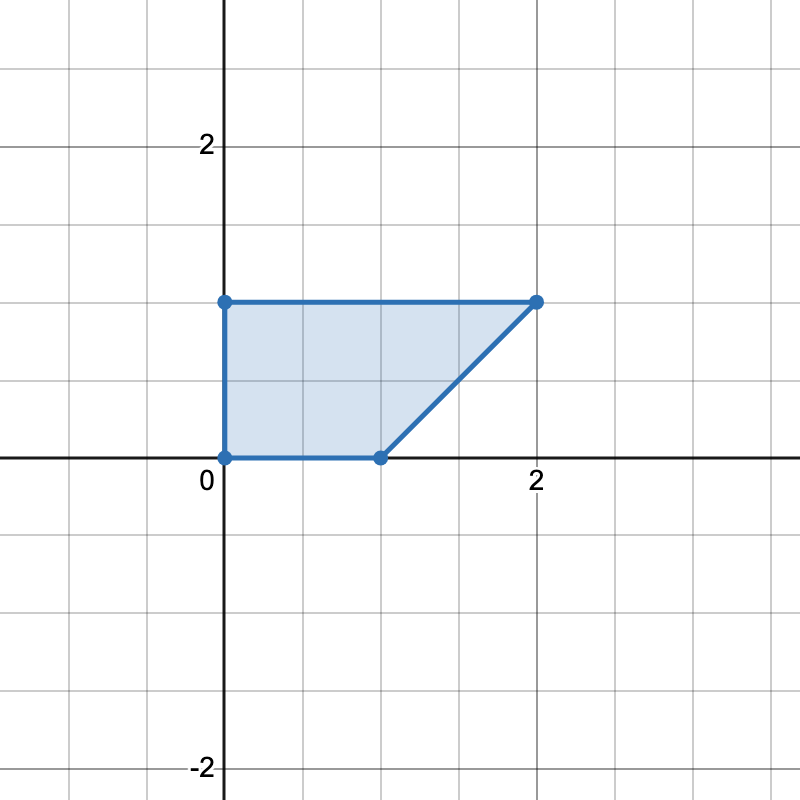
输入: points = [[0,0],[1,0],[0,1],[2,1]]
输出: 1
解释:
只有一种方式可以组成一个梯形。

说明:

  • 4 <= points.length <= 500
  • –1000 <= xi, yi <= 1000
  • 所有点两两不同。

思路

和 3623.统计梯形的数目I 类似,本题的斜率可以不是 0,需要考虑垂直于 x 轴的平行线,以及平行四边形重复统计问题。

计算两个坐标点的斜率,并根据斜率分组,再在每一组中根据截距分组。计算斜率需要除法,需要考虑精度问题。需要特殊处理垂线。对于平行四边形,有两对平行的边,在计算时会重复统计。所以还要减去平行四边形的个数,由于其两条对角线的中点是重合的,利用这一性质,按照对角线的中点分组统计。

代码

性能

3321.计算子数组的 x-sum II

目标

给你一个由 n 个整数组成的数组 nums,以及两个整数 k 和 x。

数组的 x-sum 计算按照以下步骤进行:

  • 统计数组中所有元素的出现次数。
  • 仅保留出现次数最多的前 x 个元素的每次出现。如果两个元素的出现次数相同,则数值 较大 的元素被认为出现次数更多。
  • 计算结果数组的和。

注意,如果数组中的不同元素少于 x 个,则其 x-sum 是数组的元素总和。

返回一个长度为 n - k + 1 的整数数组 answer,其中 answer[i] 是 子数组 nums[i..i + k - 1] 的 x-sum。

子数组 是数组内的一个连续 非空 的元素序列。

示例 1:

输入:nums = [1,1,2,2,3,4,2,3], k = 6, x = 2
输出:[6,10,12]
解释:
对于子数组 [1, 1, 2, 2, 3, 4],只保留元素 1 和 2。因此,answer[0] = 1 + 1 + 2 + 2。
对于子数组 [1, 2, 2, 3, 4, 2],只保留元素 2 和 4。因此,answer[1] = 2 + 2 + 2 + 4。注意 4 被保留是因为其数值大于出现其他出现次数相同的元素(3 和 1)。
对于子数组 [2, 2, 3, 4, 2, 3],只保留元素 2 和 3。因此,answer[2] = 2 + 2 + 2 + 3 + 3。

示例 2:

输入:nums = [3,8,7,8,7,5], k = 2, x = 2
输出:[11,15,15,15,12]
解释:
由于 k == x,answer[i] 等于子数组 nums[i..i + k - 1] 的总和。

说明:

  • nums.length == n
  • 1 <= n <= 10^5
  • 1 <= nums[i] <= 10^9
  • 1 <= x <= k <= nums.length

思路

//todo

  • 295.数据流的中位数
  • 480.滑动窗口中位数
  • 3013.将数组分成最小总代价的子数组 II

代码

性能

3003.执行操作后的最大分割数量

目标

给你一个下标从 0 开始的字符串 s 和一个整数 k。

你需要执行以下分割操作,直到字符串 s 变为 空:

  • 选择 s 的最长 前缀,该前缀最多包含 k 个 不同 字符。
  • 删除 这个前缀,并将分割数量加一。如果有剩余字符,它们在 s 中保持原来的顺序。

执行操作之 前 ,你可以将 s 中 至多一处 下标的对应字符更改为另一个小写英文字母。

在最优选择情形下改变至多一处下标对应字符后,用整数表示并返回操作结束时得到的 最大 分割数量。

示例 1:

输入:s = "accca", k = 2
输出:3
解释:
最好的方式是把 s[2] 变为除了 a 和 c 之外的东西,比如 b。然后它变成了 "acbca"。
然后我们执行以下操作:
1. 最多包含 2 个不同字符的最长前缀是 "ac",我们删除它然后 s 变为 "bca"。
2. 现在最多包含 2 个不同字符的最长前缀是 "bc",所以我们删除它然后 s 变为 "a"。
3. 最后,我们删除 "a" 并且 s 变成空串,所以该过程结束。
进行操作时,字符串被分成 3 个部分,所以答案是 3。

示例 2:

输入:s = "aabaab", k = 3
输出:1
解释:
一开始 s 包含 2 个不同的字符,所以无论我们改变哪个, 它最多包含 3 个不同字符,因此最多包含 3 个不同字符的最长前缀始终是所有字符,因此答案是 1。

示例 3:

输入:s = "xxyz", k = 1
输出:4
解释:
最好的方式是将 s[0] 或 s[1] 变为 s 中字符以外的东西,例如将 s[0] 变为 w。
然后 s 变为 "wxyz",包含 4 个不同的字符,所以当 k 为 1,它将分为 4 个部分。

说明:

  • 1 <= s.length <= 10^4
  • s 只包含小写英文字母。
  • 1 <= k <= 26

思路

有一个字符串 s 和一个整数 k,允许至多将 s 中的任意一个字符替换为其它小写英文字母,然后循环执行以下操作:删除字符串 s 的 最长 前缀,要求前缀中 最多 包含 k 个不同字符。求最大的删除次数。

// todo

代码

性能

3539.魔法序列的数组乘积之和

目标

给你两个整数 M 和 K,和一个整数数组 nums。

一个整数序列 seq 如果满足以下条件,被称为 魔法 序列:

  • seq 的序列长度为 M。
  • 0 <= seq[i] < nums.length
  • 2^seq[0] + 2^seq[1] + ... + 2^seq[M - 1] 的 二进制形式 有 K 个 置位。

这个序列的 数组乘积 定义为 prod(seq) = (nums[seq[0]] * nums[seq[1]] * ... * nums[seq[M - 1]])。

返回所有有效 魔法 序列的 数组乘积 的 总和 。

由于答案可能很大,返回结果对 10^9 + 7 取模。

置位 是指一个数字的二进制表示中值为 1 的位。

示例 1:

输入: M = 5, K = 5, nums = [1,10,100,10000,1000000]
输出: 991600007
解释:
所有 [0, 1, 2, 3, 4] 的排列都是魔法序列,每个序列的数组乘积是 1013。

示例 2:

输入: M = 2, K = 2, nums = [5,4,3,2,1]
输出: 170
解释:
魔法序列有 [0, 1],[0, 2],[0, 3],[0, 4],[1, 0],[1, 2],[1, 3],[1, 4],[2, 0],[2, 1],[2, 3],[2, 4],[3, 0],[3, 1],[3, 2],[3, 4],[4, 0],[4, 1],[4, 2] 和 [4, 3]。

示例 3:

输入: M = 1, K = 1, nums = [28]
输出: 28
解释:
唯一的魔法序列是 [0]。

说明:

  • 1 <= K <= M <= 30
  • 1 <= nums.length <= 50
  • 1 <= nums[i] <= 10^8

思路

代码

性能