排序后去掉工资最高与最低的求平均值。
其实不需要排序,只需找到最大与最小值,然后从总和里减去即可。
排序后去掉工资最高与最低的求平均值。
其实不需要排序,只需找到最大与最小值,然后从总和里减去即可。
明天五一假期。今天的题太友好了,循环里面判断就行了。
给你一个下标从 0 开始的 m * n 整数矩阵 grid 。矩阵中某一列的宽度是这一列数字的最大 字符串长度 。
请你返回一个大小为 n 的整数数组 ans ,其中 ans[i] 是第 i 列的宽度。
一个有 len 个数位的整数 x ,如果是非负数,那么 字符串长度 为 len ,否则为 len + 1 。
示例 1:
输入:grid = [[1],[22],[333]]
输出:[3]
解释:第 0 列中,333 字符串长度为 3 。
示例 2:
输入:grid = [[-15,1,3],[15,7,12],[5,6,-2]]
输出:[3,1,2]
解释:
第 0 列中,只有 -15 字符串长度为 3 。
第 1 列中,所有整数的字符串长度都是 1 。
第 2 列中,12 和 -2 的字符串长度都为 2 。
说明:
-10^9 <= grid[r][c] <= 10^9这个题核心就是如何计算数字的长度。我们可以枚举 9, 99, 999, 9999, 99999, 999999, 9999999, 99999999, 999999999, Integer.MAX_VALUE,分别与这些值比较,Integer.stringSize就是如此实现的。对于负数需要将长度加1 int size = (i < 0) ? stringSize(-i) + 1 : stringSize(i);。
也可以循环除以10直到0来计算长度。一个优化的点是不必求每一个数的长度,只需要求出最大值 max 与 最小值 min的长度即可。网友还提供了一个小技巧可以减少对较小值的长度计算。选取 max/10 和 -min 中的较大值来计算长度 l,取 l+1。解释如下:如果 min > 0 那么 -min < 0,我们取到 max/10 的长度,所以长度为 l+1。如果 min < 0,并且 -min > max/10,我们取到 -min,长度需要加上负号,即 l+1。这里需要解释一下 -min < max && -min > max/10 的情况,这时 max 的长度与 -min 的长度加1 是相同的。而如果 min < 0,且 -min < max/10,取 max/10 长度减小了1,所以取 l+1。
/**
 * @date 2024-04-27 18:39
 */
public class FindColumnWidth2639 {

    int[] sizeTable = {9, 99, 999, 9999, 99999, 999999, 9999999,
            99999999, 999999999, Integer.MAX_VALUE};

    int stringSize(int x) {
        int j;
        if (x < 0) {
            x = -x;
            j = 2;
        } else {
            j = 1;
        }
        for (int i = 0; ; i++) {
            if (x <= sizeTable[i]) {
                return i + j;
            }
        }
    }

    public int[] findColumnWidth(int[][] grid) {
        int n = grid[0].length;
        int[] res = new int[n];
        int[] negative = new int[n];
        for (int[] ints : grid) {
            for (int i = 0; i < n; i++) {
                if (ints[i] < negative[i]) {
                    negative[i] = ints[i];
                } else if (ints[i] > res[i]) {
                    res[i] = ints[i];
                }
            }
        }
        for (int i = 0; i < n; i++) {
            res[i] = Math.max(stringSize(res[i]), stringSize(negative[i]));
        }
        return res;
    }

}
卡车有两个油箱。给你两个整数,mainTank 表示主油箱中的燃料(以升为单位),additionalTank 表示副油箱中的燃料(以升为单位)。
该卡车每耗费 1 升燃料都可以行驶 10 km。每当主油箱使用了 5 升燃料时,如果副油箱至少有 1 升燃料,则会将 1 升燃料从副油箱转移到主油箱。
返回卡车可以行驶的最大距离。
注意:从副油箱向主油箱注入燃料不是连续行为。这一事件会在每消耗 5 升燃料时突然且立即发生。
示例 1:
输入:mainTank = 5, additionalTank = 10
输出:60
解释:
在用掉 5 升燃料后,主油箱中燃料还剩下 (5 - 5 + 1) = 1 升,行驶距离为 50km 。
在用掉剩下的 1 升燃料后,没有新的燃料注入到主油箱中,主油箱变为空。
总行驶距离为 60km 。
示例 2:
输入:mainTank = 1, additionalTank = 2
输出:10
解释:
在用掉 1 升燃料后,主油箱变为空。
总行驶距离为 10km 。
说明:
这里面的关键点在于第一次消耗完5升燃料之后会触发副油箱注入,后面消耗的5升燃料中包含有副油箱注入的1升。即第一次消耗完成后主油箱每消耗4升就会触发燃料注入。
例如主油箱有9L,副油箱有1L,那么总共可以消耗10L燃料。
注入燃料的总次数等于 1 + (mainTank -5)/4 = (mainTank - 1)/4。
/**
 * @date 2024-04-25 0:11
 */
public class DistanceTraveled2739 {

    public int distanceTraveled_v1(int mainTank, int additionalTank) {
        return 10 * (mainTank + Math.min((mainTank - 1) / 4, additionalTank));
    }

    public int distanceTraveled(int mainTank, int additionalTank) {
        int res = 0;
        while (mainTank >= 5) {
            res += 5;
            mainTank -= 5;
            if (additionalTank > 0) {
                additionalTank--;
                mainTank++;
            }
        }
        res += mainTank;
        return res * 10;
    }
}
一场比赛中共有 n 支队伍,按从 0 到 n - 1 编号。
给你一个下标从 0 开始、大小为 n * n 的二维布尔矩阵 grid 。对于满足 0 <= i, j <= n - 1 且 i != j 的所有 i, j :如果 grid[i][j] == 1,那么 i 队比 j 队 强 ;否则,j 队比 i 队 强 。
在这场比赛中,如果不存在某支强于 a 队的队伍,则认为 a 队将会是 冠军 。
返回这场比赛中将会成为冠军的队伍。
示例 1:
输入:grid = [[0,1],[0,0]]
输出:0
解释:比赛中有两支队伍。
grid[0][1] == 1 表示 0 队比 1 队强。所以 0 队是冠军。
示例 2:
输入:grid = [[0,0,1],[1,0,1],[0,0,0]]
输出:1
解释:比赛中有三支队伍。
grid[1][0] == 1 表示 1 队比 0 队强。
grid[1][2] == 1 表示 1 队比 2 队强。
所以 1 队是冠军。
说明:
grid[i][j] 的值为 0 或 1grid[i][i] 等于 0.grid[i][j] != grid[j][i] 均成立行和为n-1或者列全为0的为冠军。
/**
 * @date 2024-04-12 0:13
 */
public class FindChampion2923 {
    public int findChampion(int[][] grid) {
        int n = grid.length;
        for (int i = 0; i < n; i++) {
            int sum = 0;
            for (int j = 0; j < n; j++) {
                sum += grid[i][j];
            }
            if (sum == n - 1) {
                return i;
            }
        }
        return -1;
    }
}
给你一个按 非递减顺序 排列的数组 nums ,返回正整数数目和负整数数目中的最大值。
注意:0 既不是正整数也不是负整数。
示例 1:
输入:nums = [-2,-1,-1,1,2,3]
输出:3
解释:共有 3 个正整数和 3 个负整数。计数得到的最大值是 3 。
示例 2:
输入:nums = [-3,-2,-1,0,0,1,2]
输出:3
解释:共有 2 个正整数和 3 个负整数。计数得到的最大值是 3 。
示例 3:
输入:nums = [5,20,66,1314]
输出:4
解释:共有 4 个正整数和 0 个负整数。计数得到的最大值是 4 。
说明:
进阶:你可以设计并实现时间复杂度为 O(log(n)) 的算法解决此问题吗?
这个题简单做法就是循环计数,O(n)的时间复杂度。O(log(n))需要使用二分查找。Arrays.binarySearch() 是处理不了非严格递增的情况的,如果查找的key有多个,无法保证返回的是哪一个,通常就是中间的那一个。
这里的难点是弄清楚当有多个相同值的时候如何找到第一个。具体来说就是 low 与 high 的更新以及结束条件,自己可以用一个具体的例子来模拟查找的过程。
low == high。nums[middle] >= key 更新 high = middle,nums[middle] < key 更新 low = middle + 1。返回第一个大于等于key的index。nums[middle] > key 更新 high = middle - 1,nums[middle] <= key 更新 low = middle。为什么要 +1 或者 -1? 因为middle指的位置不等于key,不是我们要找的值,不应该再出现在下一次的查找范围内,这是能说的通的。其实最核心的目的是保证最终low、high指向同一个位置,防止出现low与high相差1,但是middle指向的位置也无法触发更新的情况。以[-3,0,0,3,4]为例,我们要找0的下界,如果low的更新不 +1,那么最终就是 low,middle 指向 -3,high 指向第一个0,这不是我们想要的。
/**
 * @date 2024-04-09 1:33
 */
public class MaximumCount2529 {

    public int maximumCount(int[] nums) {
        int pos = 0;
        int neg = 0;
        for (int i = 0; i < nums.length; i++) {
            if (nums[i] < 0) {
                neg++;
            } else if (nums[i] > 0) {
                pos = nums.length - i;
                break;
            }
        }
        return Math.max(pos, neg);
    }

    /**
     * 二分查找
     */
    public int maximumCount_v2(int[] nums) {
        int neg = bs(nums, 0);
        int pos = bs(nums, 1);
        return Math.max(neg, nums.length - pos);
    }

    public int bs(int[] nums, int key) {
        int low = 0, high = nums.length;
        while (low != high) {
            int middle = (low + high) >> 1;
            if (nums[middle] >= key) {
                high = middle;
            } else {
                low = middle + 1;
            }
        }
        return low;
    }
}
给你两棵二叉树,原始树 original 和克隆树 cloned,以及一个位于原始树 original 中的目标节点 target。
其中,克隆树 cloned 是原始树 original 的一个 副本 。
请找出在树 cloned 中,与 target 相同 的节点,并返回对该节点的引用(在 C/C++ 等有指针的语言中返回 节点指针,其他语言返回节点本身)。
注意:你 不能 对两棵二叉树,以及 target 节点进行更改。只能 返回对克隆树 cloned 中已有的节点的引用。
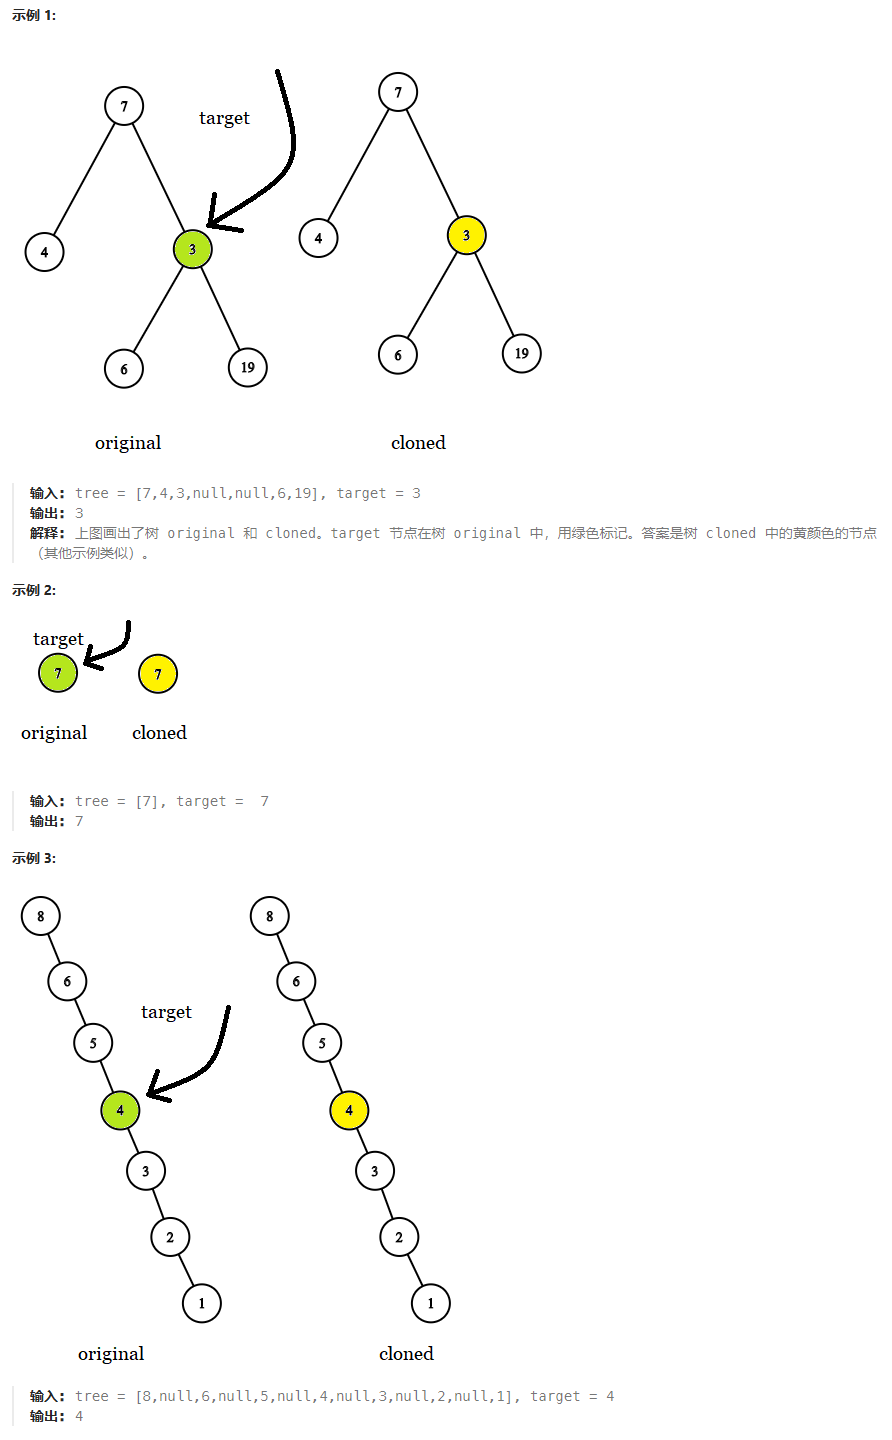
说明:
进阶:如果树中允许出现值相同的节点,将如何解答?
这道题挺简单的,这让我想起 100.相同的树 这道题,都是两棵树的同步遍历。
/**
 * @date 2024-04-03 0:01
 */
public class GetTargetCopy1379 {
    public final TreeNode getTargetCopy(final TreeNode original, final TreeNode cloned, final TreeNode target) {
        if (original == null) {
            return null;
        } else if (target.equals(original)) {
            return cloned;
        } else {
            TreeNode res = getTargetCopy(original.left, cloned.left, target);
            if (res == null) {
                res = getTargetCopy(original.right, cloned.right, target);
            }
            return res;
        }
    }
}
你的笔记本键盘存在故障,每当你在上面输入字符 'i' 时,它会反转你所写的字符串。而输入其他字符则可以正常工作。
给你一个下标从 0 开始的字符串 s ,请你用故障键盘依次输入每个字符。
返回最终笔记本屏幕上输出的字符串。
示例 1:
输入:s = "string"
输出:"rtsng"
解释:
输入第 1 个字符后,屏幕上的文本是:"s" 。
输入第 2 个字符后,屏幕上的文本是:"st" 。
输入第 3 个字符后,屏幕上的文本是:"str" 。
因为第 4 个字符是 'i' ,屏幕上的文本被反转,变成 "rts" 。
输入第 5 个字符后,屏幕上的文本是:"rtsn" 。
输入第 6 个字符后,屏幕上的文本是: "rtsng" 。
因此,返回 "rtsng" 。
示例 2:
输入:s = "poiinter"
输出:"ponter"
解释:
输入第 1 个字符后,屏幕上的文本是:"p" 。
输入第 2 个字符后,屏幕上的文本是:"po" 。
因为第 3 个字符是 'i' ,屏幕上的文本被反转,变成 "op" 。
因为第 4 个字符是 'i' ,屏幕上的文本被反转,变成 "po" 。
输入第 5 个字符后,屏幕上的文本是:"pon" 。
输入第 6 个字符后,屏幕上的文本是:"pont" 。
输入第 7 个字符后,屏幕上的文本是:"ponte" 。
输入第 8 个字符后,屏幕上的文本是:"ponter" 。
因此,返回 "ponter" 。
说明:
当输入i的时候,之前所有的输入都需要反转,i字符本身不显示。使用split无法处理连续为i以及结尾为i的情况。
最直接的做法就是模拟操作,但是反转字符串的复杂度较高。考虑使用双端队列,当反转时,相当于从队首加入字符,从队尾开始读取。
/**
 * @date 2024-04-01 8:42
 */
public class FinalString2810 {
    public String finalString_v1(String s) {
        StringBuilder res = new StringBuilder();
        Deque<Character> q = new ArrayDeque<>();
        boolean reverse = false;
        for (int i = 0; i < s.length(); i++) {
            char ch = s.charAt(i);
            if ('i' == ch) {
                reverse = !reverse;
            } else if (reverse) {
                q.push(ch);
            } else {
                q.offer(ch);
            }
        }
        Iterator<Character> it;
        if (reverse) {
            it = q.descendingIterator();
        } else {
            it = q.iterator();
        }
        while (it.hasNext()) {
            res.append(it.next());
        }
        return res.toString();
    }

    public String finalString(String s) {
        StringBuilder res = new StringBuilder();
        char[] chars = s.toCharArray();
        for (int i = 0; i < chars.length; i++) {
            if ('i' == chars[i]) {
                res.reverse();
            } else {
                res.append(chars[i]);
            }
        }
        return res.toString();
    }
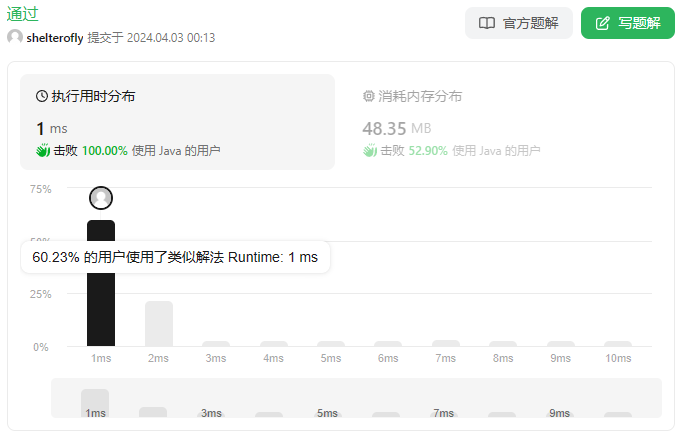
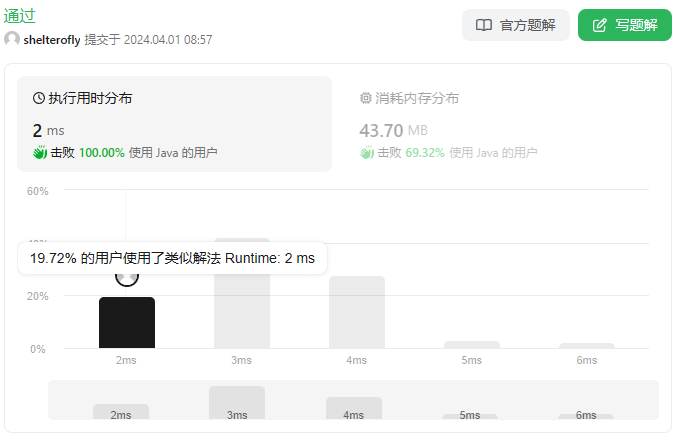
}按道理来说应该是finalString_v1更快一些,res.reverse()时间复杂度是 O(n/2),会将元素左右互换。但是leetcode显示的用时分布反而finalString更快,耗时是finalString_v1的一半2ms,应该与数据规模有关吧,字符串长度最大才100。finalString_v1有更多的流程控制,还体现不出性能。
给定一个整数数组 nums 和一个整数目标值 target,请你在该数组中找出 和为目标值 target 的那 两个 整数,并返回它们的数组下标。
你可以假设每种输入只会对应一个答案。但是,数组中同一个元素在答案里不能重复出现。
你可以按任意顺序返回答案。
示例 1:
输入:nums = [2,7,11,15], target = 9
输出:[0,1]
解释:因为 nums[0] + nums[1] == 9 ,返回 [0, 1] 。
示例 2:
输入:nums = [3,2,4], target = 6
输出:[1,2]
示例 3:
输入:nums = [3,3], target = 6
输出:[0,1]
说明:
进阶:你可以想出一个时间复杂度小于 O(n2) 的算法吗?
除了每日一题还开了一个进度,今天找个简单的来做吧。这题是leetcode的abandon,应该所有人都会遇到。
这道题我首先想到的还是暴力解法。本来是很抗拒的,但是如果可以先排序,然后找到大于target的下标来缩小范围,是不是会好一些。
但是这样会改变原数组元素的下标,还是暴力解吧。
官网的解使用了Hash表,但是我首先就把使用hash表来存储排除了,也许是觉得就是查两个下标就要存10^9个数据会不会太浪费了。这样不好,感觉思维被限制了。
再给自己强调一下,如果需要降低查询的时间复杂度,首先要考虑hash表!hash表结合了数组与链表的优点,理想情况下操作的时间复杂度为O(1),但是空间利用率不高,下标由值的hash函数来决定。
随便贴一下官网的解吧。
class Solution {
    public int[] twoSum(int[] nums, int target) {
        Map<Integer, Integer> hashtable = new HashMap<Integer, Integer>();
        for (int i = 0; i < nums.length; ++i) {
            if (hashtable.containsKey(target - nums[i])) {
                return new int[]{hashtable.get(target - nums[i]), i};
            }
            hashtable.put(nums[i], i);
        }
        return new int[0];
    }
}时间复杂度O(n)最多一次遍历,空间复杂度O(n)用于hash表开销。
给你一个下标从 0 开始的整数数组 nums 。
如果下标三元组 (i, j, k) 满足下述全部条件,则认为它是一个 山形三元组 :
请你找出 nums 中 元素和最小 的山形三元组,并返回其 元素和 。如果不存在满足条件的三元组,返回 -1 。
示例 1:
输入:nums = [8,6,1,5,3]
输出:9
解释:三元组 (2, 3, 4) 是一个元素和等于 9 的山形三元组,因为:
- 2 < 3 < 4
- nums[2] < nums[3] 且 nums[4] < nums[3]
这个三元组的元素和等于 nums[2] + nums[3] + nums[4] = 9 。可以证明不存在元素和小于 9 的山形三元组。
示例 2:
输入:nums = [5,4,8,7,10,2]
输出:13
解释:三元组 (1, 3, 5) 是一个元素和等于 13 的山形三元组,因为:
- 1 < 3 < 5
- nums[1] < nums[3] 且 nums[5] < nums[3]
这个三元组的元素和等于 nums[1] + nums[3] + nums[5] = 13 。可以证明不存在元素和小于 13 的山形三元组。
示例 3:
输入:nums = [6,5,4,3,4,5]
输出:-1
解释:可以证明 nums 中不存在山形三元组。
提示:
它标的是一道简单题,但是在我思考的过程中甚至产生了自我怀疑。以至于后面有些抓狂,直接暴力求解,不考虑性能,不考虑优雅,什么都不顾,只要能做出来。好以此来证明自己不是那么傻。
这道题让我们求数组中满足某些条件的三元组之中和最小的那一个,满足的条件就是 小 大 小,可以不连续。
暴力解法上来直接就排除了,什么动态规划直接pass。简单题需要这些吗?然后我就被上了一课,不用这些真想不出来。方法没有高低之分。
/**
 * @date 2024-03-29 0:52
 */
public class MinimumSum2908 {

    public int minimumSum(int[] nums) {
        int[] dp = new int[nums.length];
        dp[0] = Integer.MAX_VALUE;
        dp[nums.length - 1] = Integer.MAX_VALUE;
        for (int i = 1; i < nums.length; i++) {
            int tmp = i;
            int left = Integer.MAX_VALUE;
            while (i >= 1) {
                if (nums[tmp] > nums[i - 1]) {
                    left = Math.min(left, nums[i - 1]);
                }
                i--;
            }
            if (left == Integer.MAX_VALUE) {
                dp[tmp] = Integer.MAX_VALUE;
                i = tmp;
                continue;
            }
            int right = Integer.MAX_VALUE;
            i = tmp;
            while (i < nums.length - 1) {
                if (nums[tmp] > nums[i + 1]) {
                    right = Math.min(right, nums[i + 1]);
                }
                i++;
            }
            if (right != Integer.MAX_VALUE) {
                dp[tmp] = left + nums[tmp] + right;
            } else {
                dp[tmp] = Integer.MAX_VALUE;
            }
            i = tmp;
        }
        Arrays.sort(dp);
        return dp[0] == Integer.MAX_VALUE ? -1 : dp[0];
    }
}