3020.子集中元素的最大数量

目标

给你一个 正整数 数组 nums 。

你需要从数组中选出一个满足下述条件的子集:

  • 你可以将选中的元素放置在一个下标从 0 开始的数组中,并使其遵循以下模式:[x, x^2, x^4, ..., x^k/2, x^k, x^k/2, ..., x^4, x^2, x](注意,k 可以是任何 非负 的 2 的幂)。例如,[2, 4, 16, 4, 2] 和 [3, 9, 3] 都符合这一模式,而 [2, 4, 8, 4, 2] 则不符合。

返回满足这些条件的子集中,元素数量的 最大值 。

示例 1:

输入:nums = [5,4,1,2,2]
输出:3
解释:选择子集 {4,2,2} ,将其放在数组 [2,4,2] 中,它遵循该模式,且 22 == 4 。因此答案是 3 。

示例 2:

输入:nums = [1,3,2,4]
输出:1
解释:选择子集 {1},将其放在数组 [1] 中,它遵循该模式。因此答案是 1 。注意我们也可以选择子集 {2} 、{4} 或 {3} ,可能存在多个子集都能得到相同的答案。

说明:

  • 2 <= nums.length <= 10^5
  • 1 <= nums[i] <= 10^9

思路

将正整数数组 nums 的子序列按照模式放入一个下标从 0 开始的数组中,模式为 [x x^2 x^4 x^8 ... x^k/2 x^k x^k/2 ... x^8 x^4 x^2 x],k 可以是任何非负的 2 的幂,即 1、2、4、8、16……。求满足条件的子序列的最大长度。

对数组中的元素计数,如果 x 出现次数大于等于 2 则开始倍增,将长度加 2,判断 x^2 是否出现,如果出现次数大于 1,则判断 (x^2)^2 是否出现,以此类推。循环结束时判断数字的出现次数,如果为 0 需要将前面的元素作为中间元素,之前长度加了 2 这里需要减 1,如果为 1 正好作为中间元素将长度加 1。

代码


/**
 * @date 2026-06-29 17:33
 */
public class MaximumLength3020 {

    public int maximumLength(int[] nums) {
        Map<Integer, Integer> cnt = new HashMap<>();
        for (int num : nums) {
            cnt.merge(num, 1, Integer::sum);
        }
        int res = 1;
        if (cnt.get(1) != null) {
            res = Math.max(res, cnt.get(1) - (1 - cnt.get(1) % 2));
            cnt.remove(1);
        }
        for (Integer num : cnt.keySet()) {
            int l = 0;
            while (cnt.getOrDefault(num, 0) > 1) {
                l += 2;
                num *= num;
            }
            res = Math.max(res, l + (cnt.get(num) == null ? -1 : 1));
        }
        return res;
    }

}

性能

1189.”气球”的最大数量

目标

给你一个字符串 text,你需要使用 text 中的字母来拼凑尽可能多的单词 "balloon"(气球)。

字符串 text 中的每个字母最多只能被使用一次。请你返回最多可以拼凑出多少个单词 "balloon"。

示例 1:

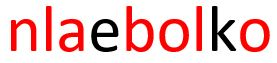
输入:text = "nlaebolko"
输出:1

示例 2:

输入:text = "loonbalxballpoon"
输出:2

示例 3:

输入:text = "leetcode"
输出:0

提示:

  • 1 <= text.length <= 10^4
  • text 全部由小写英文字母组成

注意:本题与 2287.重排字符形成目标字符串 相同。

思路

使用字符串 text 中的字母拼凑单词 balloon,求最多能拼出多少个。

单词由 1 个 a、1 个 b、1 个 n、2 个 l 和 2 个 o 组成。对 text 中的字母计数,统计相关字母频次的最小值即可(l 与 o 需要除以 2)。

代码


/**
 * @date 2026-06-22 9:05
 */
public class MaxNumberOfBalloons1189 {

    public int maxNumberOfBalloons_v1(String text) {
        char[] cnt = new char[26];
        for (char c : text.toCharArray()) {
            cnt[c - 'a']++;
        }
        int res = Integer.MAX_VALUE;
        res = Math.min(res, cnt[0]);
        res = Math.min(res, cnt[1]);
        res = Math.min(res, cnt[11] / 2);
        res = Math.min(res, cnt[13]);
        res = Math.min(res, cnt[14] / 2);
        return res;
    }

}

性能

2196.根据描述创建二叉树

目标

给你一个二维整数数组 descriptions ,其中 descriptions[i] = [parenti, childi, isLefti] 表示 parenti 是 childi 在 二叉树 中的 父节点,二叉树中各节点的值 互不相同 。此外:

  • 如果 isLefti == 1 ,那么 childi 就是 parenti 的左子节点。
  • 如果 isLefti == 0 ,那么 childi 就是 parenti 的右子节点。

请你根据 descriptions 的描述来构造二叉树并返回其 根节点 。

测试用例会保证可以构造出 有效 的二叉树。

示例 1:

输入:descriptions = [[20,15,1],[20,17,0],[50,20,1],[50,80,0],[80,19,1]]
输出:[50,20,80,15,17,19]
解释:根节点是值为 50 的节点,因为它没有父节点。
结果二叉树如上图所示。

示例 2:

输入:descriptions = [[1,2,1],[2,3,0],[3,4,1]]
输出:[1,2,null,null,3,4]
解释:根节点是值为 1 的节点,因为它没有父节点。 
结果二叉树如上图所示。 

说明:

  • 1 <= descriptions.length <= 10^4
  • descriptions[i].length == 3
  • 1 <= parenti, childi <= 10^5
  • 0 <= isLefti <= 1
  • descriptions 所描述的二叉树是一棵有效二叉树

思路

有一个二维数组 descriptions,descriptions[i] = [parenti, childi, left or right] 描述了二叉树中的一对父子关系,即 parenti 是 childi 的父节点,childi 是 parenti 的左或者右孩子(取决于 1 或者 0)。重建二叉树并返回根节点。题目保证描述的是有效二叉树,且节点值不重复。

使用哈希表保存树节点,根据描述关系将节点连接起来,最终需要找出根节点,可以将孩子节点存到哈希集合中,返回不在该集合的节点即可。

代码


/**
 * @date 2026-06-08 11:34
 */
public class CreateBinaryTree2196 {

    public TreeNode createBinaryTree(int[][] descriptions) {
        Map<Integer, TreeNode> map = new HashMap<>();
        Set<Integer> childKeySet = new HashSet<>();
        for (int[] description : descriptions) {
            int parentKey = description[0];
            map.putIfAbsent(parentKey, new TreeNode(parentKey));
            TreeNode parent = map.get(parentKey);
            int childKey = description[1];
            childKeySet.add(childKey);
            map.putIfAbsent(childKey, new TreeNode(childKey));
            TreeNode child = map.get(childKey);
            if (description[2] == 1) {
                parent.left = child;
            } else {
                parent.right = child;
            }
        }
        for (int[] description : descriptions) {
            int parentKey = description[0];
            if (!childKeySet.contains(parentKey)) {
                return map.get(parentKey);
            }
        }
        return null;
    }
}

性能

3121.统计特殊字母的数量II

目标

给你一个字符串 word。如果 word 中同时出现某个字母 c 的小写形式和大写形式,并且 每个 小写形式的 c 都出现在第一个大写形式的 c 之前,则称字母 c 是一个 特殊字母 。

返回 word 中 特殊字母 的数量。

示例 1:

输入:word = "aaAbcBC"
输出:3
解释:
特殊字母是 'a'、'b' 和 'c'。

示例 2:

输入:word = "abc"
输出:0
解释:
word 中不存在特殊字母。

示例 3:

输入:word = "AbBCab"
输出:0
解释:
word 中不存在特殊字母。

说明:

  • 1 <= word.length <= 2 * 10^5
  • word 仅由小写和大写英文字母组成。

思路

有一个字符串 word,返回其中大小写同时存在,且 所有小写都在其大写之前出现 的的字母个数。

与 3120_统计特殊字母的数量I 相比,本题多了顺序条件。

使用两个数组标记字母(无论大小写,统一用 0 ~ 25 表示)是否被计数以及是否被删除:

  • 如果当前字母是大写:
    • 之前大小写都已出现(计数 或者 删除都已经处理过了),直接跳过
    • 对应的小写已经出现,计数(上面的条件保证了不会重复计数),并标记为已计数
  • 如果当前字母是小写:
    • 之前大小写都已出现,且已计数(不一定被计数,因为小写可能后出现)未被标记为已删除,则计数减一,并标记为已删除
    • 注意如果之前只出现过大写,不用处理,因为没有被计数

代码


/**
 * @date 2026-05-26 9:06
 */
public class NumberOfSpecialChars3121 {

    /**
     * A(65):  1000001
     * Z(90):  1011010
     * a(97):  1100001
     * z(122): 1111010
     * 31: 0011111
     * 32: 0100000
     */
    public int numberOfSpecialChars_v1(String word) {
        Set<Integer> set = new HashSet<>();
        int n = word.length();
        boolean[] rm = new boolean[26];
        boolean[] add = new boolean[26];
        int res = 0;
        for (int i = 0; i < n; i++) {
            int c = word.charAt(i);
            // 将字母映射到 0 ~ 25,不区分大小写
            int index = (c & 31) - 1;
            // flag 为 0 表示大写字母,为 1 是小写字母
            int flag = c & 32;
            // 如果之前已经遇到过字母的大小写
            if (set.contains(c) && set.contains(c ^ (1 << 5))) {
                // 如果当前是大写,无需处理,因为需要加的话前面已经加了,需要减的前面已经减了
                if (flag == 0){
                    continue;
                }
                // 如果当前是小写,计数过且没减过,计数减一,并标记
                // 注意,如果之前只遇到过大写,不用处理,因为不满足条件没有被计数
                if (!rm[index] && add[index]){
                    rm[index] = true;
                    res--;
                }
            }
            // 如果当前是大写并且之前出现过小写,标记并计数
            if (flag == 0 && set.contains(c + 32)){
                add[index] = true;
                res++;
            }
            set.add(c);
        }
        return res;
    }

}

性能
3120.统计特殊字母的数量I

目标

给你一个字符串 word。如果 word 中同时存在某个字母的小写形式和大写形式,则称这个字母为 特殊字母 。

返回 word 中 特殊字母 的数量。

示例 1:

输入:word = "aaAbcBC"
输出:3
解释:
word 中的特殊字母是 'a'、'b' 和 'c'。

示例 2:

输入:word = "abc"
输出:0
解释:
word 中不存在大小写形式同时出现的字母。

示例 3:

输入:word = "abBCab"
输出:1
解释:
word 中唯一的特殊字母是 'b'。

说明:

  • 1 <= word.length <= 50
  • word 仅由小写和大写英文字母组成。

思路

有一个字符串 word,返回其中大小写同时存在的的字母个数。

使用哈希表记录已经出现的字母,如果已经同时出现过大小写,需要跳过,避免重复计数。否则,如果当前字母是小写,判断对应大写是否在哈希表中,如果当前字母是大写,判断对应小写是否在哈希表中,将当前字母加入哈希表。

代码


/**
 * @date 2026-05-26 8:51
 */
public class NumberOfSpecialChars3120 {

    public int numberOfSpecialChars(String word) {
        Set<Character> set = new HashSet<>();
        int n = word.length();
        int res = 0;
        for (int i = 0; i < n; i++) {
            char c = word.charAt(i);
            if (set.contains(c) && (set.contains((char) (c + 32)) || set.contains((char) (c - 32)))) {
                continue;
            }
            if ((c < 'a' && set.contains((char) (c + 32))) || (c >= 'a' && set.contains((char) (c - 32)))) {
                res++;
            }
            set.add(c);
        }
        return res;
    }

}

性能
3043.最长公共前缀的长度

目标

给你两个 正整数 数组 arr1 和 arr2 。

正整数的 前缀 是其 最左边 的一位或多位数字组成的整数。例如,123 是整数 12345 的前缀,而 234 不是 。

设若整数 c 是整数 a 和 b 的 公共前缀 ,那么 c 需要同时是 a 和 b 的前缀。例如,5655359 和 56554 有公共前缀 565 和 5655,而 1223 和 43456 没有 公共前缀。

你需要找出属于 arr1 的整数 x 和属于 arr2 的整数 y 组成的所有数对 (x, y) 之中最长的公共前缀的长度。

返回所有数对之中最长公共前缀的长度。如果它们之间不存在公共前缀,则返回 0 。

示例 1:

输入:arr1 = [1,10,100], arr2 = [1000]
输出:3
解释:存在 3 个数对 (arr1[i], arr2[j]) :
- (1, 1000) 的最长公共前缀是 1 。
- (10, 1000) 的最长公共前缀是 10 。
- (100, 1000) 的最长公共前缀是 100 。
最长的公共前缀是 100 ,长度为 3 。

示例 2:

输入:arr1 = [1,2,3], arr2 = [4,4,4]
输出:0
解释:任何数对 (arr1[i], arr2[j]) 之中都不存在公共前缀,因此返回 0 。
请注意,同一个数组内元素之间的公共前缀不在考虑范围内。

说明:

  • 1 <= arr1.length, arr2.length <= 5 * 10^4
  • 1 <= arr1[i], arr2[i] <= 10^8

思路

有两个数组 arr1 和 arr2,返回所有数对 (arr1[i], arr2[j]) 中最长公共前缀的长度。

将 arr1 中每个数字的前缀都计入哈希表,同时判断 arr2 中每个元素的的前缀是否在哈希表中,取前缀的最大长度即可。

或者可以将 arr1 的每个元素都加入 字典树,枚举 arr2 的每一个元素,计算其在字典树中公共前缀的最大长度。

代码


/**
 * @date 2026-05-21 9:03
 */
public class LongestCommonPrefix3043 {

    static class Trie {
        public Trie[] children = new Trie[10];

        public void insert(int num) {
            String s = Integer.toString(num);
            Trie cur = this;
            for (int i = 0; i < s.length(); i++) {
                int d = s.charAt(i) - '0';
                if (cur.children[d] == null) {
                    cur.children[d] = new Trie();
                }
                cur = cur.children[d];
            }
        }

        public int prefixLength(int num) {
            String s = Integer.toString(num);
            Trie cur = this;
            int l = 0;
            for (int i = 0; i < s.length(); i++) {
                int d = s.charAt(i) - '0';
                if (cur.children[d] == null) {
                    break;
                }
                cur = cur.children[d];
                l++;
            }
            return l;
        }
    }

    public int longestCommonPrefix(int[] arr1, int[] arr2) {
        Trie root = new Trie();
        for (int num : arr1) {
            root.insert(num);
        }
        int res = 0;
        for (int num : arr2) {
            res = Math.max(res, root.prefixLength(num));
        }
        return res;
    }

}

性能
2657.找到两个数组的前缀公共数组

目标

给你两个下标从 0 开始长度为 n 的整数排列 A 和 B 。

A 和 B 的 前缀公共数组 定义为数组 C ,其中 C[i] 是数组 A 和 B 到下标为 i 之前公共元素的数目。

请你返回 A 和 B 的 前缀公共数组 。

如果一个长度为 n 的数组包含 1 到 n 的元素恰好一次,我们称这个数组是一个长度为 n 的 排列 。

示例 1:

输入:A = [1,3,2,4], B = [3,1,2,4]
输出:[0,2,3,4]
解释:i = 0:没有公共元素,所以 C[0] = 0 。
i = 1:1 和 3 是两个数组的前缀公共元素,所以 C[1] = 2 。
i = 2:1,2 和 3 是两个数组的前缀公共元素,所以 C[2] = 3 。
i = 3:1,2,3 和 4 是两个数组的前缀公共元素,所以 C[3] = 4 。

示例 2:

输入:A = [2,3,1], B = [3,1,2]
输出:[0,1,3]
解释:i = 0:没有公共元素,所以 C[0] = 0 。
i = 1:只有 3 是公共元素,所以 C[1] = 1 。
i = 2:1,2 和 3 是两个数组的前缀公共元素,所以 C[2] = 3 。

说明:

  • 1 <= A.length == B.length == n <= 50
  • 1 <= A[i], B[i] <= n
  • 题目保证 A 和 B 两个数组都是 n 个元素的排列。

思路

有两个长度为 n 的整数排列 A 和 B,整数 1 ~ n 恰好出现一次,C[i] 表示 A[0, i] 和 B[0, i] 中的公共元素个数(注意不是公共前缀长度),返回 C。

直接依题意模拟,使用哈希表(或者数组计数),A 中元素 +1, B 中元素 -1,然后累加出现次数为 0 的元素个数即可。注意元素相同时避免重复累加,并且当前位置公共元素的个数应该以前一个位置公共元素的个数为基础再加上新增公共元素的个数。

网友题解使用的是位运算,注意到 n <= 50,可以使用两个 long 型变量来记录元素是否出现,将这两个变量相与然后 bitcount 就是公共元素个数。

代码


/**
 * @date 2026-05-20 8:58
 */
public class FindThePrefixCommonArray2657 {

    public int[] findThePrefixCommonArray_v1(int[] A, int[] B) {
        int n = A.length;
        int[] cnt = new int[n + 1];
        int[] C = new int[n];
        cnt[A[0]]++;
        cnt[B[0]]--;
        if (A[0] == B[0]) {
            C[0] = 1;
        }
        for (int i = 1; i < n; i++) {
            cnt[A[i]]++;
            cnt[B[i]]--;
            C[i] = C[i - 1];
            if (cnt[A[i]] == 0) {
                C[i]++;
            }
            if (A[i] != B[i] && cnt[B[i]] == 0) {
                C[i]++;
            }
        }
        return C;
    }

}

性能

2540.最小公共值

目标

给你两个整数数组 nums1 和 nums2 ,它们已经按非降序排序,请你返回两个数组的 最小公共整数 。如果两个数组 nums1 和 nums2 没有公共整数,请你返回 -1 。

如果一个整数在两个数组中都 至少出现一次 ,那么这个整数是数组 nums1 和 nums2 公共 的。

示例 1:

输入:nums1 = [1,2,3], nums2 = [2,4]
输出:2
解释:两个数组的最小公共元素是 2 ,所以我们返回 2 。

示例 2:

输入:nums1 = [1,2,3,6], nums2 = [2,3,4,5]
输出:2
解释:两个数组中的公共元素是 2 和 3 ,2 是较小值,所以返回 2 。

说明:

  • 1 <= nums1.length, nums2.length <= 10^5
  • 1 <= nums1[i], nums2[j] <= 10^9
  • nums1 和 nums2 都是 非降序 的。

思路

有两个升序数组 nums1 和 nums2,返回它们最小的公共元素。

双指针,如果不相等优先移动元素值较小的下标。

代码


/**
 * @date 2026-05-19 8:46
 */
public class GetCommon2540 {

    public int getCommon(int[] nums1, int[] nums2) {
        for (int a = 0, b = 0; a < nums1.length && b < nums2.length; ) {
            if (nums1[a] == nums2[b]) {
                return nums1[a];
            } else if (nums1[a] < nums2[b]) {
                a++;
            } else {
                b++;
            }
        }
        return -1;
    }
}

性能

1345.跳跃游戏IV

目标

给你一个整数数组 arr ,你一开始在数组的第一个元素处(下标为 0)。

每一步,你可以从下标 i 跳到下标 i + 1 、i - 1 或者 j :

  • i + 1 需满足:i + 1 < arr.length
  • i - 1 需满足:i - 1 >= 0
  • j 需满足:arr[i] == arr[j] 且 i != j

请你返回到达数组最后一个元素的下标处所需的 最少操作次数 。

注意:任何时候你都不能跳到数组外面。

示例 1:

输入:arr = [100,-23,-23,404,100,23,23,23,3,404]
输出:3
解释:那你需要跳跃 3 次,下标依次为 0 --> 4 --> 3 --> 9 。下标 9 为数组的最后一个元素的下标。

示例 2:

输入:arr = [7]
输出:0
解释:一开始就在最后一个元素处,所以你不需要跳跃。

示例 3:

输入:arr = [7,6,9,6,9,6,9,7]
输出:1
解释:你可以直接从下标 0 处跳到下标 7 处,也就是数组的最后一个元素处。

说明:

  • 1 <= arr.length <= 5 * 10^4
  • -10^8 <= arr[i] <= 10^8

思路

有一个数组 nums,从下标 0 开始移动,目标是到达下标 n - 1。每次移动可以移动到相邻的位置,或者满足 nums[j] == nums[i] 的位置 j。返回最少移动次数。

与 3629.通过质数传送到达终点的最少跳跃次数 类似,那个题目质数列表的处理比这个相同元素列表稍微复杂一些。

思路都是 BFS,从起点出发将下一个可以到达的节点加入队列,直到到达终点。关键点是处理完一次相同元素下标列表之后要清空,避免重复访问。

小优化:只取相同元素的首尾下标。

代码


/**
 * @date 2026-05-18 8:59
 */
public class MinJumps1345 {

    public int minJumps_v1(int[] arr) {
        int n = arr.length;
        Map<Integer, List<Integer>> map = new HashMap<>();
        int i = 0;
        while (i < n) {
            int start = i;
            while (i < n && arr[i] == arr[start]) {
                i++;
            }
            map.computeIfAbsent(arr[start], x -> new ArrayList<>()).add(start);
            if (start != i - 1) {
                map.get(arr[start]).add(i - 1);
            }
        }
        List<Integer> q = new ArrayList<>();
        q.add(0);
        boolean[] visited = new boolean[n];
        int res = 0;
        while (!q.isEmpty()) {
            List<Integer> tmp = new ArrayList<>();
            for (Integer cur : q) {
                if (cur == n - 1) {
                    return res;
                }
                if (cur > 0 && !visited[cur - 1]) {
                    visited[cur - 1] = true;
                    tmp.add(cur - 1);
                }
                if (!visited[cur + 1]){
                    visited[cur + 1] = true;
                    tmp.add(cur + 1);
                }
                if (map.get(arr[cur]) != null) {
                    for (Integer index : map.get(arr[cur])) {
                        if (!visited[index]){
                            visited[index] = true;
                            tmp.add(index);
                        }
                    }
                    map.remove(arr[cur]);
                }
            }
            q = tmp;
            res++;
        }
        return res;
    }

}

性能
2784.检查数组是否是好的

目标

给你一个整数数组 nums ,如果它是数组 base[n] 的一个排列,我们称它是个 好 数组。

base[n] = [1, 2, ..., n - 1, n, n] (换句话说,它是一个长度为 n + 1 且包含 1 到 n - 1 恰好各一次,包含 n 两次的一个数组)。比方说,base[1] = [1, 1] ,base[3] = [1, 2, 3, 3] 。

如果数组是一个好数组,请你返回 true ,否则返回 false 。

注意:数组的排列是这些数字按任意顺序排布后重新得到的数组。

示例 1:

输入:nums = [2, 1, 3]
输出:false
解释:因为数组的最大元素是 3 ,唯一可以构成这个数组的 base[n] 对应的 n = 3 。但是 base[3] 有 4 个元素,但数组 nums 只有 3 个元素,所以无法得到 base[3] = [1, 2, 3, 3] 的排列,所以答案为 false 。

示例 2:

输入:nums = [1, 3, 3, 2]
输出:true
解释:因为数组的最大元素是 3 ,唯一可以构成这个数组的 base[n] 对应的 n = 3 ,可以看出数组是 base[3] = [1, 2, 3, 3] 的一个排列(交换 nums 中第二个和第四个元素)。所以答案为 true 。

示例 3:

输入:nums = [1, 1]
输出:true
解释:因为数组的最大元素是 1 ,唯一可以构成这个数组的 base[n] 对应的 n = 1,可以看出数组是 base[1] = [1, 1] 的一个排列。所以答案为 true 。

示例 4:

输入:nums = [3, 4, 4, 1, 2, 1]
输出:false
解释:因为数组的最大元素是 4 ,唯一可以构成这个数组的 base[n] 对应的 n = 4 。但是 base[n] 有 5 个元素而 nums 有 6 个元素。所以答案为 false 。

说明:

  • 1 <= nums.length <= 100
  • 1 <= num[i] <= 200

思路

有一个长度为 n + 1 的数组 nums,判断它是否是数组 [1, 2, 3, ……, n - 1, n, n] 的一个排列。

注意到目标数组的元素与下标的关系为 nums[i] = i + 1, i < n,特殊处理后两个位置,使用一个指针 p 指向下标 n - 1。遍历数组 nums 前 n 个元素,如果当前位置的元素值不满足条件,就将其与满足条件的位置(当 nums[i] < n 时,取 nums[i] - 1,当 nums[i] == n 时取 p,当 nums[i] > n 直接返回 false)上的元素值交换,如果目标位置的元素值已经满足条件或者 n 的出现次数超过两次,返回 false。最后返回 nums[n] == n 即可。

代码


/**
 * @date 2026-05-14 9:40
 */
public class IsGood2784 {

    public boolean isGood(int[] nums) {
        int n = nums.length - 1;
        int p = n - 1;
        for (int i = 0; i < n; i++) {
            while (nums[i] != i + 1) {
                int index = nums[i] - 1;
                if (nums[i] > n || (nums[i] < n && nums[index] == nums[i]) || (nums[i] == n && p > n)) {
                    return false;
                }
                if (nums[i] == n) {
                    index = p++;
                }
                int tmp = nums[index];
                nums[index] = nums[i];
                nums[i] = tmp;
            }
        }
        return nums[n] == n;
    }
}

性能